01
파일이 남았다면 바이트 입력 사용
파일과 Hex에서만 UTF-8의 잘못된 바이트 위치를 0부터 계산합니다. 이미 디코딩된 문자열에는 과거 파일의 바이트 오프셋이 없습니다.
Unicode 및 국제화
원본을 보존한 채 인코딩별 결과를 비교하세요.
문자열, Hex 또는 파일을 입력하세요.
문자열과 파일 바이트는 이 브라우저에서만 처리되며 업로드되지 않습니다.
입력이나 설정이 바뀌어 다시 분석합니다.
후보는 추정입니다. 왕복이 가능해도 실제 원문이라는 뜻은 아닙니다.
한글 깨짐 복구는 오래된 CSV를 열었더니 이름이 우리처럼 보일 때 필요합니다. 정상 표기를 아는 짧은 부분부터 골라 후보의 단어와 문장 부호를 대조하세요.
원본 파일이 남아 있다면 복사한 문자열보다 파일 바이트를 먼저 사용하세요. 깨진 문자 복구 과정에서 이미 �로 바뀐 값은 붙여 넣은 문자만으로 알아낼 수 없습니다.
보존된 증거와 추정한 결과를 분리해 볼 수 있습니다.
한글 깨짐 복구는 파일이나 Hex의 원본 바이트를 유지하고 UTF-8, EUC-KR 등으로 읽은 결과를 나란히 보여 줍니다. 후보를 바꿔도 원본은 손대지 않습니다.
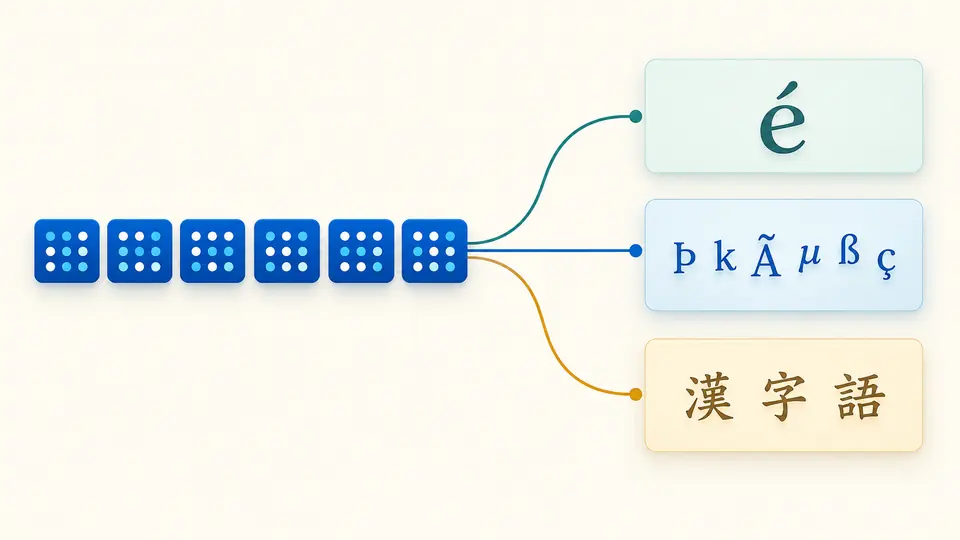
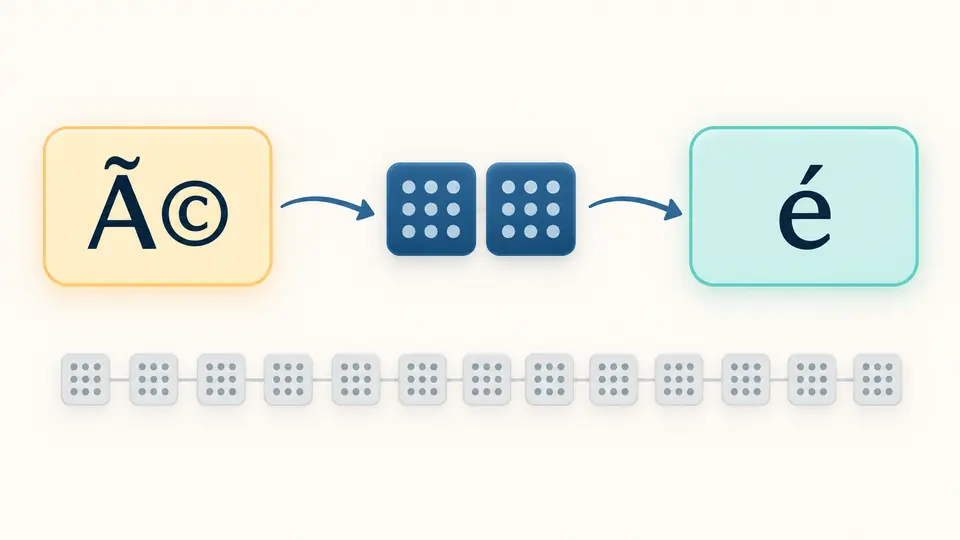
붙여 넣은 모지바케 복구는 잘못 읽힌 문자에서 바이트를 되찾아 원래 기록된 인코딩으로 다시 해석합니다. 어떤 경로를 가정했는지 표시합니다.
파일과 Hex에서만 UTF-8의 잘못된 바이트 위치를 0부터 계산합니다. 이미 디코딩된 문자열에는 과거 파일의 바이트 오프셋이 없습니다.
원래 기록된 인코딩과 잘못 읽힌 인코딩을 각각 고르세요. 자동 후보는 잠시 입력이 멈춘 뒤 다시 계산되며 설정을 바꾸면 이전 결과의 복사가 막힙니다.
왕복 가능한 경로라도 실제 원문을 뜻하지 않습니다. 사람 이름과 문장 부호를 확인하고 선택한 결과만 새 UTF-8 파일로 내려받으세요.
원본 바이트에서 잘못된 시작 바이트, 이어지는 바이트, 잘린 시퀀스를 위치와 함께 보여 줍니다. 붙여 넣은 글자로 파일의 오류 위치를 꾸며 내지 않습니다.
EUC-KR UTF-8 변환 상황뿐 아니라 서유럽, 중국어, 일본어 계열의 잘못된 읽기도 후보로 비교합니다. 자동 순서는 언어 판정이 아닙니다.
후보를 선택해도 입력은 바뀌지 않습니다. 결과는 UTF-8 텍스트로, 원본은 별도의 바이트 파일로 저장할 수 있습니다.
원본 CSV가 있다면 파일 모드에서 바이트를 보존하고 EUC-KR 후보를 살펴보세요. 이 도구는 내용을 미리 보고 새 텍스트로 저장하지만 CSV 구조를 편집하지는 않습니다.
잘못 읽힌 인코딩을 역으로 적용할 수 있으면 후보가 나옵니다. �나 ?로 대체된 바이트는 문자열에 남지 않아 완전 복구를 보장할 수 없습니다.
아니요. 결과 다운로드는 UTF-8만 제공합니다. EUC-KR로 저장하면 표현할 수 없는 문자가 ?로 바뀔 위험이 있어 별도의 손실 검사 없이 제공하지 않습니다.
기록된 바이트를 다른 문자 인코딩으로 읽을 때 생깁니다. 예를 들어 UTF-8 바이트를 기존 지역 인코딩으로 해석하면 엉뚱한 글자가 나옵니다.
아니요. 여러 번 변환했거나 원래 바이트가 사라진 경우, 글꼴에 문자가 없는 경우는 이 후보 목록만으로 해결할 수 없습니다.
판단하기 어려운 예가 있나요?