01
Datei statt kopiertem Text verwenden
Datei- und Hex-Modus behalten die wirklichen Bytes und melden UTF-8-Fehler mit nullbasiertem Offset. Eingefügter Text enthält keine historischen Bytepositionen der Datei.
Unicode und Internationalisierung
Vergleiche Kodierungen, während der ursprüngliche Text oder die Bytes erhalten bleiben.
Text, Hex oder Datei eingeben.
Text und Dateibytes bleiben zur Verarbeitung in diesem Browser; sie werden nicht hochgeladen.
Eingabe oder Einstellung geändert. Neue Analyse steht aus.
Kandidaten sind Vermutungen. Umkehrbarkeit beweist nicht den historischen Wortlaut.
Mojibake reparieren ist nötig, wenn aus „ä“ plötzlich „ä“ wird oder ein alter Export unlesbar erscheint. Prüfe zuerst einen kurzen Abschnitt mit bekannten Namen; daran lassen sich Kandidaten besser beurteilen als an einzelnen Zeichen.
Ist die Originaldatei noch vorhanden, nutze ihre Bytes. Wer nur Zeichensalat reparieren will, der bereits als Unicode-Text kopiert wurde, hat keine sichere Auskunft mehr über verlorene Quellbytes.
Die Quelle bleibt greifbar, während unterschiedliche Deutungen nebeneinander stehen.
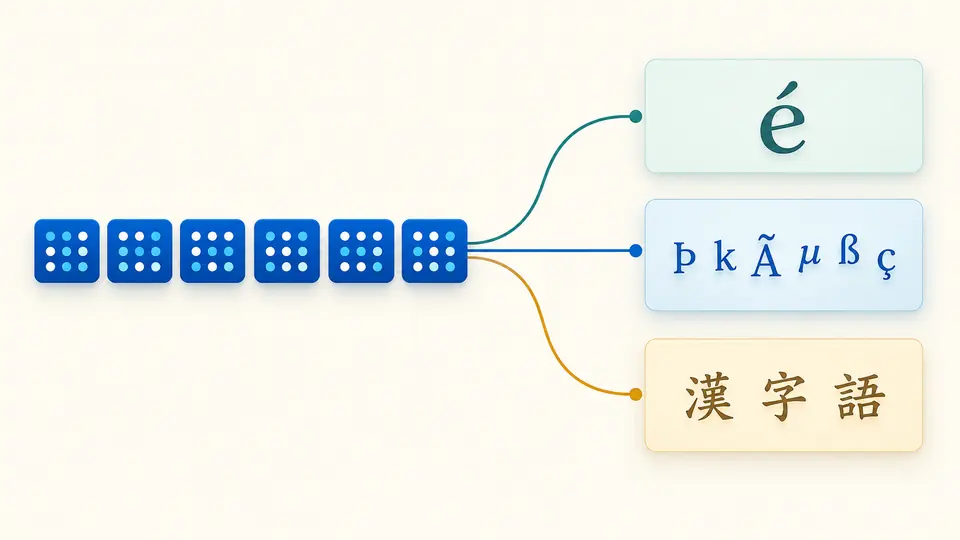
Beim Mojibake reparieren bleiben Datei oder Hex-Folge unverändert. UTF-8, GBK und andere Decoder liefern getrennte Vorschauen; keine Auswahl schreibt die Quelle um.
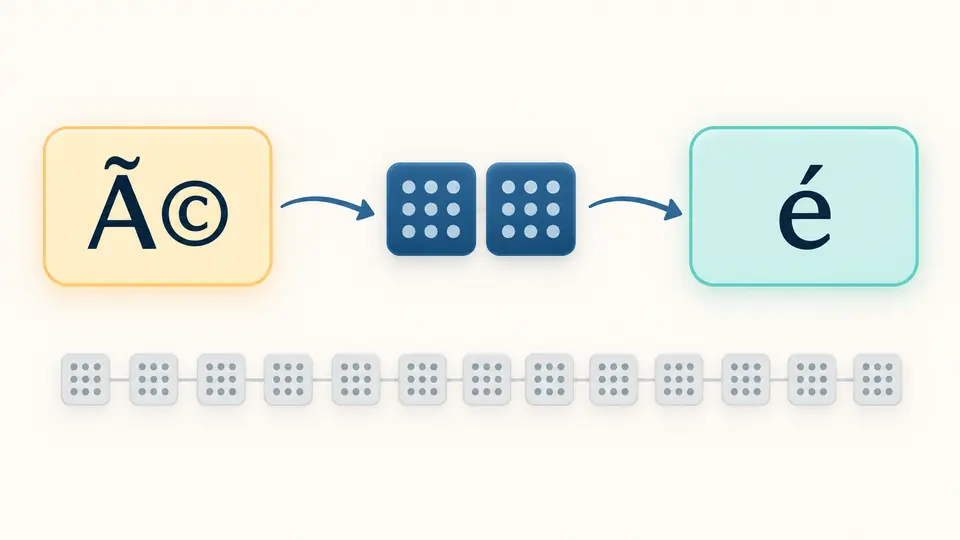
Bei eingefügtem „café“ bildet das Werkzeug die Zeichen gemäß der irrtümlichen Kodierung zurück auf Bytes und liest diese gemäß der ursprünglichen Kodierung. Die Kette wird sichtbar.
Datei- und Hex-Modus behalten die wirklichen Bytes und melden UTF-8-Fehler mit nullbasiertem Offset. Eingefügter Text enthält keine historischen Bytepositionen der Datei.
„Ursprünglich geschrieben als“ meint die erste Kodierung, „fälschlich gelesen als“ die spätere Fehlinterpretation. Das ist keine Aufforderung, die Kodierung konvertieren zu lassen.
Automatische Kandidaten erscheinen nach einer kurzen Pause. Bei Änderungen wird der alte Export gesperrt. Prüfe Namen, Umlaute und Satzzeichen, ehe du eine Kopie speicherst.
Nur für Originalbytes werden ungültige Start- und Folgebytes sowie abgebrochene Sequenzen mit Position ausgegeben. So lassen sich kaputte Umlaute reparieren, ohne Fehlerstellen zu erfinden.
Westliche, kyrillische und ostasiatische Lesarten erscheinen als getrennte Kandidaten. Ein Text-Kodierung-Konverter würde nur eine gewählte Richtung ausführen; hier bleibt der Vergleich sichtbar.
Die ausgewählte Vorschau wird als neue UTF-8-Textdatei geladen. Die ursprünglichen Bytes können separat gespeichert werden, damit ein falscher Versuch keine Beweise vernichtet.
Nein. Kandidaten beruhen auf möglichen Umkehrketten und einer vorläufigen Sortierung. Prüfe sie anhand bekannter Wörter; Reversibilität ist kein Beweis für die damalige Kodierung.
Vielleicht sind die benötigten Bytes schon durch � ersetzt worden, oder der Schaden entstand auf einem nicht unterstützten Weg. Versuche die Originaldatei oder wähle eine manuelle Kette.
Eine lokale Datei kann gelesen werden, ohne sie zu ändern. Das Ergebnis wird als neue UTF-8-Datei gespeichert; Datenbankeinträge und die Quelldatei werden nicht überschrieben.
Nein. Die Analyse und der Dateizugriff laufen im Browser. Kopieren und Herunterladen arbeiten mit dem Ergebnis auf diesem Gerät.
Wenn die Datei noch existiert, vergleiche die Bytevorschauen für UTF-8 und chinesische Kodierungen. Bei nur eingefügtem Text probiere die entsprechende Fehl-Lesart manuell und prüfe die Bedeutung.
Fehlt ein besonderer Fehlerfall?
Nutze Mojibake reparieren für einen kurzen Ausschnitt und sichere erst den Kandidaten, dessen Namen und Satzzeichen zum Kontext passen.