Unicode und Internationalisierung

Unsichtbare Zeichen erkennengespeicherte Unterschiede sichtbar machen

Prüfen Sie Fundstellen und Wirkung, bevor Sie Text verändern.

Unsichtbare Zeichen erkennen

Eingabetext

Gefundene Positionen

Der Text bleibt in diesem Browser und wird nicht hochgeladen.

Jede Bereinigungskategorie bestätigen

Anfangs ist nichts ausgewählt. Die Auswahl bestätigt die beschriebene Wirkung. Erneut prüfen und vor dem Anwenden die Vorschau ansehen.

Feste Teilmenge aus Unicode 17.0.0: 521 Codepunkte plus einzelne Surrogate. Keine vollständige Sichtbarkeitsprüfung oder Sicherheitsbewertung. Offizielle Zeichennamen bleiben in Unicode-Schreibweise.

Offset und Index beginnen bei 0, Zeile und Spalte bei 1. Spalten zählen Codepunkte, keine sichtbaren Zellen. CRLF ist ein Umbruch; CR, LF, NEL, LS und PS ebenso. Beide CRLF-Zeichen gehören zur vorherigen Zeile.

Bis zu 100.000 UTF-16-Einheiten. Unveränderte CR/CRLF bleiben wie vom Browser empfangen; neu eingegebene Umbrüche nutzen LF. Der Editor kann normalisierte Umbrüche anzeigen.

Markierungen dienen nur der Anzeige und werden nicht eingefügt. Steuerzeichen erscheinen in Speicherreihenfolge, statt ausgeführt zu werden. Kontext: höchstens 24 UTF-16-Einheiten je Seite.

Text eingeben oder Beispiel laden, dann Zeichen prüfen.

Unsichtbare Zeichen erkennen hilft, wenn zwei Zeilen gleich aussehen und der Vergleich trotzdem fehlschlägt. Ein geschütztes Leerzeichen ist ein anderer Codepunkt als der normale Abstand auf der Tastatur. Ein Nullbreite-Leerzeichen kann sogar mitten in einem scheinbar zusammenhängenden Wort stehen.

Beginnen Sie mit einem kurzen Ausschnitt, der den Fehler reproduziert. Versteckte Zeichen können aus Webseiten, Tabellen oder Textverarbeitung stammen. Ein Fund sagt, was im Text vorhanden ist; er beweist weder eine bestimmte Herkunft noch eine schädliche Absicht.

Unsichtbare Zeichen erkennen und gezielt beurteilen

Eine Fundstelle statt eines vagen Verdachts

Mit Unsichtbare Zeichen erkennen sehen Sie jeden Treffer im Zusammenhang. Zwischen einer Zahl und ihrer Einheit kann ein anderes Leerzeichen stehen als erwartet. Codepunkt und Position erklären dann, weshalb ein Datenimport oder ein exakter Zeichenkettenvergleich anders reagiert.

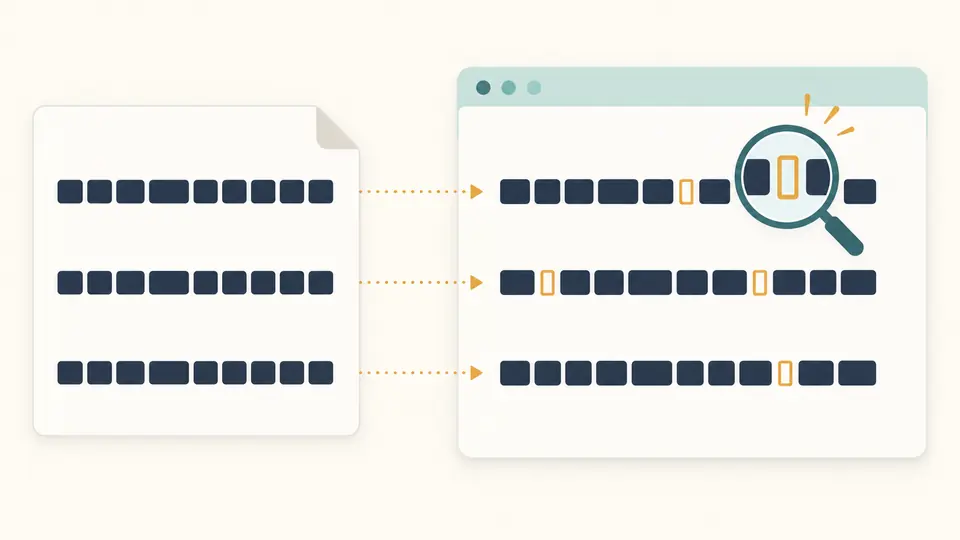
Ähnlich aussehende Textzeilen mit farbigen Markierungen an versteckten Positionen.

Notwendige Verbindungen behalten

ZWJ und ZWNJ steuern Verbindungen in Schrift und Emoji. Anfangs ist keine Bereinigungskategorie ausgewählt. Sie können unerwünschte Trennzeichen gezielt bearbeiten und die Zeichen behalten, deren Funktion für den vorliegenden Text notwendig ist.

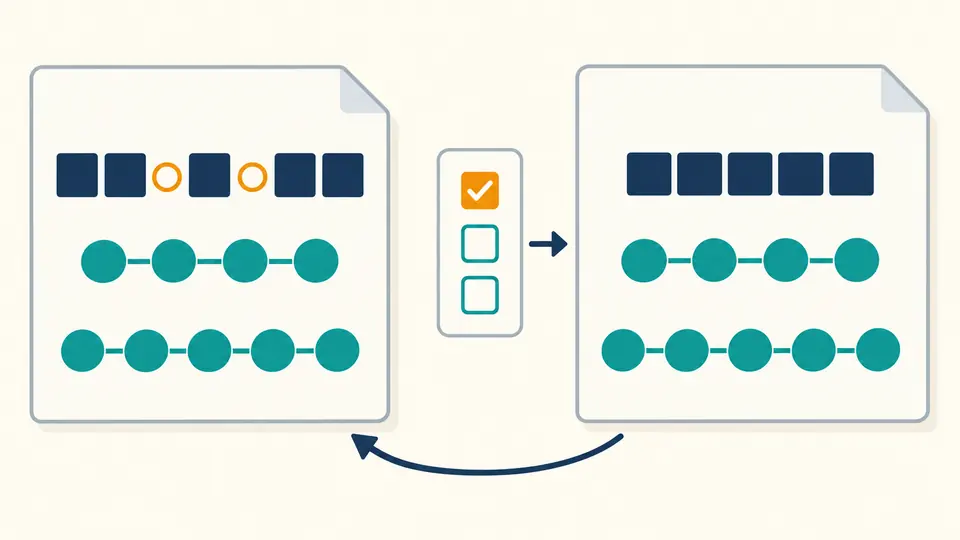
Eine ausgewählte Markierungskategorie verschwindet, während verbundene Symbolgruppen erhalten bleiben.

Erst prüfen, dann Änderungen bestätigen

01

Nach jeder Änderung erneut prüfen

Die Prüfung läuft manuell über die Schaltfläche oder Ctrl/Cmd+Enter. Änderungen an Text oder Kategorien machen den bisherigen Befund ungültig und sperren den Export. Prüfen Sie erneut, bevor Sie eine Bereinigungsvorschau erstellen.

02

Ersetzen von Löschen unterscheiden

Besondere Leerzeichen werden durch gewöhnliche Leerzeichen ersetzt. Andere ausgewählte Kategorien werden gelöscht. Vergleichen Sie beide Textfassungen und die Anzahl der Änderungen; bei Steuerzeichen können auch Tabulatoren und Zeilenumbrüche verschwinden.

03

Eine Rückkehrmöglichkeit behalten

Erst Anwenden überschreibt die Eingabe und aktualisiert den Befund. Rückgängig stellt den vorherigen Text samt Ergebnis wieder her. Auch Beispiel und Leeren zeigen eine Vorschau, wenn vorhandener Text ersetzt werden soll.

Welche Informationen der Befund liefert

Codepunkt und Wirkung im Kontext

Jeder Treffer enthält U+Code, Name und Kategorie. Im diagnostischen Kontext erscheinen Steuerzeichen als sichtbare Markierungen in Speicherreihenfolge. Richtungszeichen können die Anzeige dieses Ausschnitts deshalb nicht erneut umordnen und die Fundstelle verdecken.

Drei ausdrücklich getrennte Koordinaten

UTF-16-Offset und Codepunktindex beginnen bei null, Zeile und Spalte bei eins. Spalten zählen Codepunkte. Ein Zeichen außerhalb der Basisebene belegt zwei UTF-16-Einheiten; deshalb kann sein Index vom technischen String-Offset abweichen.

Gesamter Befund trotz kurzer Liste

Die Anzeige erweitert sich in Schritten von 50 Treffern. Der JSON-Bericht enthält alle Funde und numerischen Positionen, aber nicht den vollständigen Quelltext. Der Textexport liefert die geprüfte Eingabe, erst nach dem Anwenden die bereinigte Fassung.

Umfang und Grenzen der Bearbeitung

Feste Prüftabelle aus Unicode 17
Geprüft werden Steuer- und Formatzeichen, Nicht-ASCII-Leerraum, Variationsselektoren und festgelegte Füllzeichen. Formatzeichen sind nicht automatisch unsichtbar oder schädlich. Normale ASCII-Leerzeichen, ähnlich aussehende Buchstaben und allgemeine kombinierende Akzente gehören nicht zum Prüfumfang. Erfasste Füllzeichen: U+034F / U+115F / U+1160 / U+17B4 / U+17B5 / U+2800 / U+3164 / U+FFA0.
Logische Zeilen statt Bildschirmumbruch
CRLF gilt als ein Umbruch; CR, LF, NEL, LS und PS beginnen ebenfalls neue Zeilen. Spalten sind weder Bytepositionen noch sichtbare Zellen. Geprüft wird der vom Browser übergebene Text, nicht die ursprüngliche Bytefolge einer Datei.
Jede Kategorie braucht Ihre Auswahl
Es gibt keine vorgewählte Bereinigung. Leerraumersetzung entfernt unter anderem den Schutz vor einem Zeilenumbruch. Gelöschte Steuerzeichen können Zeilen oder Spalten verbinden; entfernte Joiner, Variationsselektoren und Richtungszeichen können korrekte Sprachdarstellung verändern.
Längenlimit und einzelne Surrogate
Die Grenze beträgt 100.000 UTF-16-Einheiten. Größere Eingaben werden abgelehnt, nicht abgeschnitten. Ungepaarte Surrogate werden gemeldet, aber nicht repariert. Kopieren und Speichern als Text sind dann gesperrt, damit keine verlustbehaftete Ersetzung erfolgt; JSON bleibt verfügbar.

Unsichtbare Zeichen erkennen: häufige Fragen

Warum sehen zwei Zeilen identisch aus, stimmen aber nicht überein?

Ein NBSP und ein gewöhnliches Leerzeichen können gleich aussehen, sind aber unterschiedliche Zeichen. Auch ein Zeichen ohne sichtbare Breite kann einen Namen unterbrechen. Vergleichen Sie die gemeldeten Codes, bevor Sie die Ursache in der Datenbank oder im Vergleichsprogramm suchen.

Woher kommen unsichtbare Zeichen?

Häufige Quellen sind kopierter Webtext, PDF-Auszüge, Tabellen und Textverarbeitung. Solche Zeichen steuern Abstände, Umbrüche oder Schriftverbindungen. Der Befund kann ihre Position zeigen, aber nicht feststellen, welches Programm sie wann eingefügt hat.

Wie entferne ich unsichtbare Zeichen aus meiner Liste?

Wählen Sie nur die unerwünschten Kategorien, prüfen Sie erneut und öffnen Sie die Vorschau. Besondere Leerzeichen werden ersetzt, andere ausgewählte Zeichen entfernt. Anwenden bestätigt die Änderung; danach können Sie die aktuelle Textfassung kopieren oder herunterladen.

Werden normale Leerzeichen entfernt?

Gewöhnliche ASCII-Leerzeichen bleiben unverändert. Besondere Leerzeichen können durch sie ersetzt werden. Tabulatoren und Zeilenumbrüche zählen dagegen als Steuerzeichen und werden nur gelöscht, wenn Sie diese Kategorie auswählen und die Vorschau ausdrücklich anwenden.

Können unsichtbare Zeichen erkannt werden?

Ja, soweit die Zeichen zur festen Prüftabelle gehören. Das ist keine vollständige Prüfung der Sichtbarkeit in sämtlichen Schriften oder Schriftarten. Eine leere Trefferliste bedeutet weder, dass alle Zeichen sichtbar sind, noch dass der Text sicher ist.

Sollten wir eine Fundstelle genauer prüfen?

Zum verdächtigen Ausschnitt zurück

Unsichtbare Zeichen erkennen liefert die Grundlage für eine gezielte Änderung. Prüfen Sie einen kleinen Fehlerfall und bestätigen Sie nur Kategorien, deren Wirkung Sie beabsichtigen.