01
Mit NFC beginnen, alle vier prüfen
NFC ist vorausgewählt, doch NFC, NFD, NFKC und NFKD werden zusammen berechnet. Bei identischem Aussehen helfen U+-Werte und UTF-8-Bytes, die tatsächliche Änderung zu erkennen.
Unicode und Internationalisierung
Alle vier Formen werden einzeln mit dem ursprünglichen Text verglichen.
Die Vorschau zeigt höchstens 4.000 Zeichen; Kopie und Download enthalten alles.
Der Text wird nur in diesem Browser verarbeitet und nicht hochgeladen.
Höchstens 10.000 UTF-16-Einheiten; größere Eingaben werden nicht abgeschnitten.
Die Unicode-Version der Normalisierung stammt vom Browser und wird nicht fest zugesichert.
Text eingeben oder ein Beispiel wählen.
Zwei Namen sehen gleich aus, lassen sich aber nicht gleich finden? Ein Akzent kann als fertiges Zeichen oder als Grundbuchstabe plus kombinierendes Zeichen gespeichert sein. Die Unicode-Normalisierung zeigt diese Abweichung im Code statt nur im Schriftbild.
Vor dem Vereinheitlichen von Dateinamen oder Eingaben lohnt sich ein Blick auf NFC und NFD. Die Unicode-Normalisierung zeigt auch, was NFKC und NFKD an Breite, Ligaturen oder hochgestellten Zeichen verändern würden.
Das Schriftbild sagt nichts über die gespeicherte Folge.
NFC-Konverter und NFD-Zerlegung werden hier nicht nacheinander ausgeführt: Jede der vier Formen entsteht unabhängig aus dem Original. So ist sichtbar, welche Form bereits vorliegt.
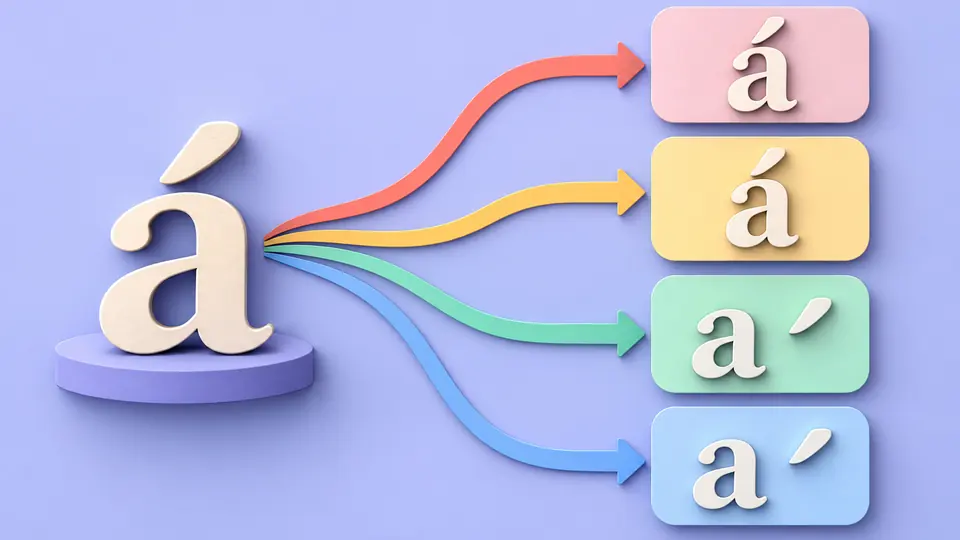
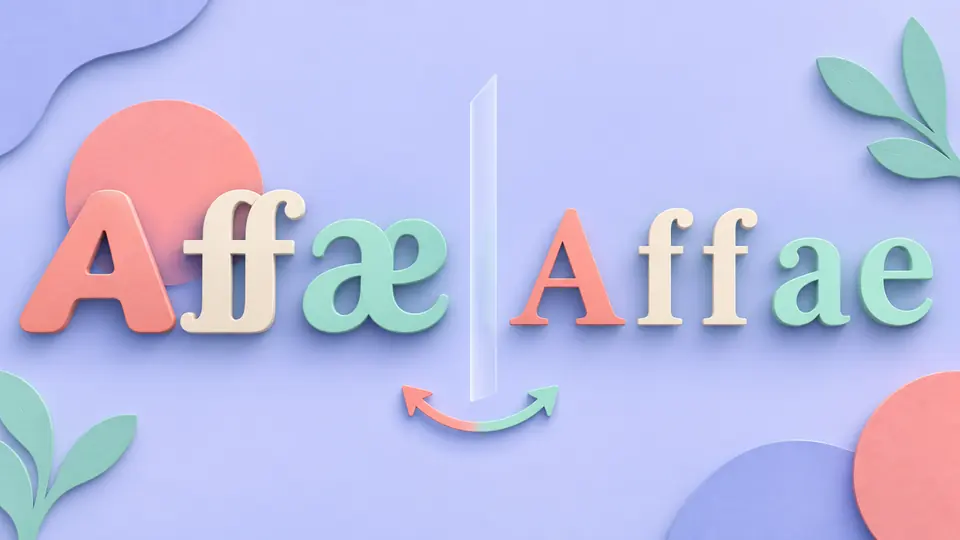
NFKC kann Vollbreitenbuchstaben oder Ligaturen in gewöhnliche Buchstaben überführen. Die Unicode-Normalisierung markiert den Bereich und zeigt die Bytes, bevor Sie den Originaltext ersetzen.
NFC ist vorausgewählt, doch NFC, NFD, NFKC und NFKD werden zusammen berechnet. Bei identischem Aussehen helfen U+-Werte und UTF-8-Bytes, die tatsächliche Änderung zu erkennen.
Gesamter Text erhält Zeilenenden. Der Zeilenmodus prüft jeden Eintrag separat, auch leere, und verbindet Ausgaben mit LF. Für unveränderte CRLF-Trennzeichen den Gesamtmodus wählen.
Eine hervorgehobene Änderung kann mehrere Codepunkte umfassen. Kopieren und Herunterladen liefern das vollständige Ergebnis. Bei ausgeschalteter Automatik startet Strg/Cmd+Enter die Prüfung.
Unicode normalisieren lässt sich kanonisch oder mit Kompatibilitätsabbildungen. Die Übersicht nennt je Form den Abgleich mit dem Original sowie Codepunkt- und Bytezahlen.
Zusammensetzen und Zerlegen sind keine eindeutige Zeichen-zu-Zeichen-Zuordnung. Die Anzeige gruppiert Änderungen und listet die U+-Folgen und UTF-8-Bytes vor und nach der Umwandlung.
Die Bildschirmvorschau ist begrenzt, die exportierte Ausgabe vollständig. Das Ersetzen der Eingabe verlangt eine Vorschau; einmaliges Rückgängigmachen stellt Eingabe und Ergebnisse wieder her.
Für gewöhnlichen Text ist NFC oft ein guter Ausgangspunkt. Wenn das Zielsystem ausdrücklich eine zerlegte Form verlangt, verwenden Sie NFD. Die Anforderungen des Zielsystems sind entscheidend.
NFKC ist sinnvoll, wenn Kompatibilitätsunterschiede wie Vollbreite oder Ligaturen absichtlich vereinheitlicht werden sollen. Prüfen Sie vorher die Vorschau, weil diese Abbildung Information verlieren kann.
Nein. Das Entfernen kombinierender Zeichen ist ein zusätzlicher Schritt und nicht dasselbe wie Normalisierung; Transliteration geht noch weiter und ersetzt Schriftzeichen. Beides führt dieses Werkzeug nicht aus.
Eine Zeichenfolge kann äußerlich gleich bleiben, obwohl ihre Codepunkte anders gespeichert sind. Der Vergleich zeigt U+-Werte und UTF-8-Bytes, damit Sie diese Änderung erkennen.
Nein. Unicode-Normalisierung ist keine Spoofing-Erkennung. Ähnlich aussehende Zeichen aus anderen Schriften und unsichtbare Steuerzeichen müssen getrennt geprüft werden.
Ist eine Änderung unklar?
Nehmen Sie die kürzeste problematische Zeichenfolge und vergleichen Sie die vier Ergebnisse, bevor Sie eines übernehmen.