Unicode und Internationalisierung

Unicode-InspektorZeichen, Einheiten und Bytes unterscheiden

Text oder Hexwerte prüfen und die gespeicherte Folge nachvollziehen.

Unicode-Inspektor

Text oder codierte Eingabe

Ausgabevorschau

Die Vorschau zeigt höchstens 4.000 Ausgabezeichen. Kopieren und Download enthalten die gesamte Ausgabe. Die Textvorschau verwendet maskierte Diagnosemarkierungen.

Die Eingabe bleibt in diesem Browser und wird nicht hochgeladen.

Text: höchstens 10.000 UTF-16-Einheiten. Codierte Eingabe: höchstens 200.000 Zeichen, decodiert höchstens 10.000 Einheiten. Codepunkte als U+HEX, 0xHEX oder HEX; Bytes zweistellig, optional mit 0x. Leerraum oder Kommas trennen Werte. Keine Escape-Sequenzen oder HTML-Entitäten.

Namen: Unicode 17.0.0. Grapheme: Intl.Segmenter des Browsers; dessen Unicode-Version ist nicht abrufbar und kann abweichen. Offizielle Namen und Steuerzeichen-Aliasse bleiben englisch.

Byte-Reihenfolge ausdrücklich wählen. Anfängliches U+FEFF bleibt erhalten; BOM wird weder erkannt noch entfernt oder ergänzt. Keine Normalisierung. Vom Browser unverändert gelieferte CR/CRLF bleiben erhalten; das Textfeld zeigt Umbrüche als LF.

Detailpositionen zählen UTF-16-Einheiten ab 0; das Ende ist exklusiv. Fehlerzeilen, Spalten und Bytepositionen beginnen bei 1. Fehlende Bytes zeigen direkt hinter die Eingabe. Skalarzählungen schließen einzelne Surrogate aus.

Text eingeben oder Beispiel laden.
Der Unicode-Inspektor hilft, wenn die Unicode-Suche einen Namen liefert, aber noch nicht erklärt, warum eine Zeichenkette länger als erwartet ist. Ein Codepunkt, eine UTF-16-Einheit und ein sichtbares Zeichen sind unterschiedliche Größen. Hier stehen sie nebeneinander.

Prüfen Sie den tatsächlich kopierten Ausschnitt: Ein zusammengesetztes ä kann aus einem Buchstaben und einem kombinierenden Trema bestehen. Gleiche Darstellung garantiert keine identische Bytefolge. Die Untersuchung verändert weder Akzente noch Leerraum.

Unicode-Inspektor: Unterschiede im Detail

Grapheme mit ihren Bestandteilen vergleichen

Der Unicode-Inspektor macht aus einer vermeintlichen Längenabweichung einen überprüfbaren Befund. Die Graphemansicht gruppiert zusammengehörige Codepunkte; die Einzelansicht nennt deren UTF-16-Positionen. So lässt sich eine Kombination aus Grundbuchstabe und Akzent von einem vorgefertigten Zeichen unterscheiden.

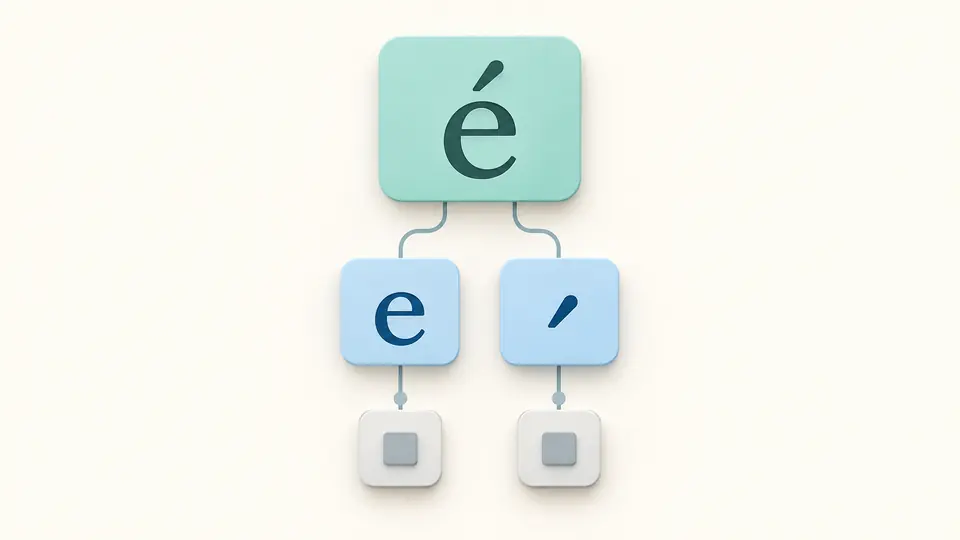
Ein Buchstabe mit kombinierendem Akzent als ein Graphem und zwei getrennte Codepunkte beziehungsweise Einheiten.

Hexbytes mit fester Reihenfolge zurücklesen

Wählen Sie UTF-8, UTF-16LE/BE oder UTF-32LE/BE passend zur Quelle. Die Decodierung weist ungültige Folgen zurück und markiert ihre Position. Ein vorangestelltes FEFF wird als Inhalt behalten, statt heimlich die Byte-Reihenfolge umzuschalten.

Zeichen und Bytegruppen mit Pfeilen in beide Richtungen, ohne Textbeschriftung.

Vom Hexwert zur überprüfbaren Ausgabe

01

Format vor dem Einfügen bestimmen

U+0041 und 0x41 sind Codepunktwerte; 41 ist im Byteformat ein einzelnes Byte. Trennen Sie Werte durch Leerraum oder Kommas. Ein durchgehender Hexblock ist keine gültige Byteeingabe. Escape-Sequenzen werden nicht ausgewertet.

02

Aktualisierung und Ersetzung kontrollieren

Automatisch wird nach 250 ms Eingabepause geprüft. Ohne Automatik starten Sie per Prüfen oder Ctrl/Cmd+Enter. Beispiel und Leeren zeigen bei vorhandener Eingabe erst eine Vorschau; Anwenden bestätigt, Rückgängig stellt den vorherigen Zustand her. Bei leerer Eingabe lädt das Beispiel direkt.

03

Vollständigen Bericht auswählen

JSON ist vorausgewählt. Die Detailtabelle wächst um jeweils 50 Einträge, die Ausgabevorschau endet nach 4.000 Zeichen. Kopieren und Download enthalten trotzdem alle Ergebnisse. Nach einer Änderung warten Sie auf die neue Prüfung.

Informationen für Fehlersuche und Vergleich

Nachvollziehbare Namensgrundlage

Die Namensdaten stammen aus Unicode 17.0.0. Steuerzeichen-Aliasse sind separat gekennzeichnet. Private Nutzung, Nichtzeichen, Surrogate und nicht zugewiesene Werte erhalten eine Typangabe statt eines erfundenen Namens.

Positionen für Zeichenkettenoperationen

Start und exklusives Ende zählen UTF-16-Einheiten ab null. Ein Zeichen außerhalb der Basisebene belegt zwei Einheiten. Die Fehleranzeige nutzt hingegen Zeile, Spalte und Byteposition ab eins.

Mehrere exportierbare Darstellungen

Vergleichen Sie U+-Diagnose, UTF-8-Bytes, UTF-16/32 mit expliziter Reihenfolge und UTF-16-Codeeinheiten. Die Textvorschau zeigt sichere Markierungen; die Textkopie enthält bei gültigem Text die echten Zeichen.

Was unverändert bleibt und was abgelehnt wird

Strikte Skalarwerte statt Reparatur
Codepunkte außerhalb U+10FFFF und Surrogate sind als codierte Eingabe unzulässig. UTF-8 muss vollständig und kürzestmöglich sein. UTF-16 verlangt gepaarte Surrogate, UTF-32 gültige Skalarwerte und vollständige Vierergruppen.
Einzelne Surrogate bleiben Diagnosematerial
Im Textmodus werden ungepaarte Einheiten untersucht und separat gezählt. Grapheme sowie Text- und Byteexport sind dann gesperrt. JSON, U+-Diagnose und UTF-16-Einheiten bleiben kopierbar; Surrogatdiagnosen sind keine rücklesbaren Skalarwerte.
Begrenzte Eingabe, vollständige Ausgabe
Text darf 10.000 UTF-16-Einheiten enthalten. Codierte Eingabe darf 200.000 Zeichen umfassen, ihr decodierter Text höchstens 10.000 Einheiten. Zu lange Eingaben werden abgelehnt, nicht abgeschnitten. Dateiimport, Namenssuche und Blockfilter fehlen.
Keine erfundene Segmentierungsversion
Grapheme kommen aus Intl.Segmenter des Browsers. Die verwendete Unicode-Version wird von dieser API nicht gemeldet. Ohne diese Funktion gibt es keine Graphemzählung. Normalisierung, BOM-Ergänzung und automatische Zeichensäuberung finden nicht statt.

Unicode-Inspektor: häufige Fragen

Warum fehlt ein Emoji in der Suche?

Diese Seite sucht nicht in einer Emoji-Liste. Fügen Sie das Emoji als Text ein. Sein Fehlen in einer anderen Suche kann an deren Datenstand oder Suchweise liegen; die Darstellung hängt zudem von der Schrift ab. Mehrteilige Emoji erscheinen als mehrere Codepunkte.

Was kopiert die Zeichenansicht im Unterschied zur Codepunktansicht?

Die Detailansicht ändert das ausgewählte Ausgabeformat nicht. Textausgabe kopiert die tatsächlichen Zeichen, U+-Ausgabe ihre Diagnosewerte. Sichtbare Markierungen der Textvorschau werden nicht als Ersatzzeichen kopiert. Bei einzelnen Surrogaten ist Textausgabe gesperrt.

Worin unterscheiden sich Unicode-Block und Kategorie?

Ein Block ist ein benannter Bereich von Codepunkten, eine allgemeine Kategorie beschreibt Eigenschaften wie Buchstabe oder Zahl. Dieses Werkzeug liefert keine vollständige Block- oder Kategorienübersicht; die Typangabe erläutert vor allem Werte ohne offiziellen Namen.

Lässt sich ein Zeichen aus UTF-8-Hexbytes ermitteln?

Ja. Wählen Sie UTF-8 als Eingabeformat und geben Sie etwa C3 A4 für ä ein. Bytes brauchen je zwei Hexziffern und Trennzeichen. Ungültige Folgen werden mit einer Position gemeldet, ohne sie durch Ersatzzeichen zu verdecken.

Welche Angaben enthält ein exportierter Bericht?

Der JSON-Bericht enthält die vollständige Analyse mit Zählungen, Codepunkten, Positionen, Namen beziehungsweise Typen und Codierungsangaben. Die Tabellenbegrenzung kürzt ihn nicht. Andere Ausgabeformate liefern jeweils die gewählte Darstellung des geprüften Texts.

Fehlt eine Erklärung zu einem Befund?

Einen konkreten Fehlerfall untersuchen

Nutzen Sie den Unicode-Inspektor für den kleinsten Ausschnitt, der den Fehler zeigt. Vergleichen Sie zuerst Positionen und Codierung, bevor Sie im ursprünglichen System Änderungen vornehmen.