01
Eingabetyp auswählen
Einen Tag ohne Semikolon im Standardmodus prüfen. Bei Accept-Language samt q-Werten oder Headernamen den zweiten Modus wählen; beides folgt nicht derselben Grammatik.
Unicode & i18n
Einzelnen Tag oder Accept-Language-Header wählen; q-Parameter gehören nur zum Header.
Die Auswertung bleibt im Browser; die Eingabe wird weder gesendet noch gespeichert.
Prüfung läuft…
IANA-Registerstand: …
Prüfung läuft…
Bei de-CH ist die Region klar, bei sr-Latn-RS steht zuerst die Schrift. Mit BCP 47 Sprach-Tag prüfen bleiben Eingabe und zerlegte Felder nebeneinander, damit aus einem Buchstabendreher keine falsche Gebietsschema Kennung wird.
Wer einen Sprachtag validieren oder Sprachcode prüfen möchte, sieht Syntax und Register getrennt. Die Accept-Language Gewichtung ist ein anderer Eingabetyp und bekommt einen eigenen Modus.
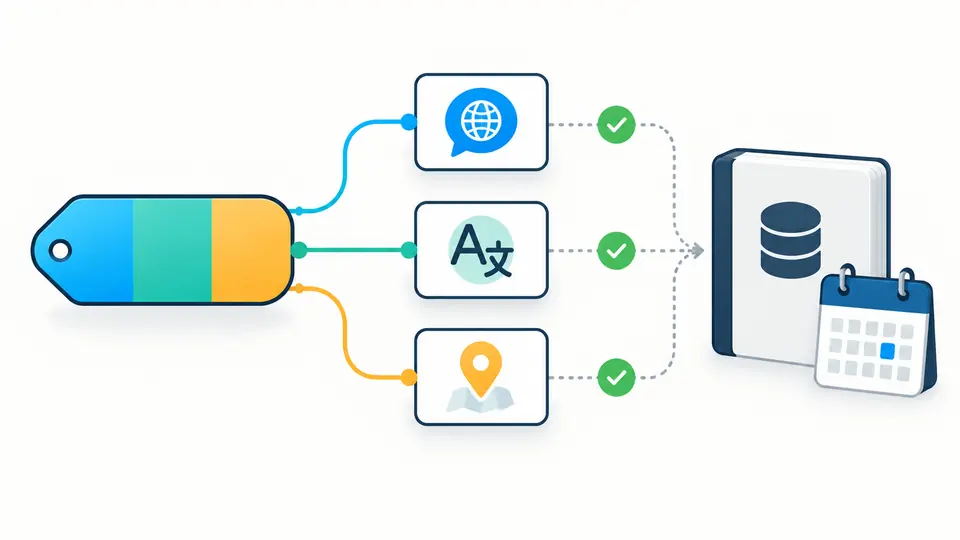
BCP 47 Sprach-Tag prüfen zeigt Sprache, Schrift, Region, Varianten und Erweiterungen einzeln. Danach werden öffentliche Subtags gegen den datierten IANA-Stand geprüft; eine bloße Browserakzeptanz reicht nicht als Registrierung.
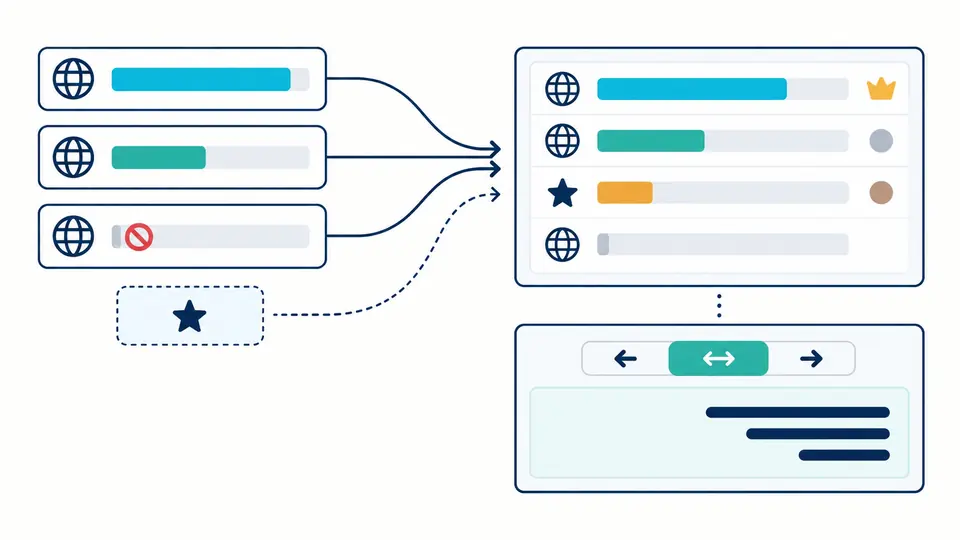
Der Header-Modus sortiert Bereiche nach q und erhält bei Gleichstand ihre ursprüngliche Reihenfolge. q=0 bleibt als ausgeschlossen sichtbar. Der daneben getrennte RTL-Test steuert Text, nicht die Spracheinstellung.
Einen Tag ohne Semikolon im Standardmodus prüfen. Bei Accept-Language samt q-Werten oder Headernamen den zweiten Modus wählen; beides folgt nicht derselben Grammatik.
Großschreibung und veraltete Codes erscheinen als Vorschlag, die Eingabe bleibt unberührt. Der IANA-Stand zeigt, wann registrierte Subtags beurteilt wurden; x-Teile haben keine öffentliche Bedeutung.
Nach 350 ms Ruhe wird automatisch geprüft. Ist die Automatik aus, nutzen Sie Prüfen oder Ctrl/Cmd+Enter. Alte Ergebnisse dürfen nach einer Änderung nicht exportiert werden.
Sprache, erweiterte Sprache, Schrift, Region, Varianten und Erweiterungen haben eigene Zeilen. Doppelte Varianten oder Erweiterungskennungen lösen einen Fehler aus.
Das File-Date des IANA-Registers steht beim Ergebnis. Bevorzugte Werte veralteter Einträge und die kanonische Browserform werden getrennt gezeigt, statt Unterschiede der Datenstände zu verdecken.
Ein fehlendes q zählt als 1, q=0 als nicht akzeptiert, und höchstens drei Nachkommastellen sind zulässig. * ist ein Sprachbereich, kein registrierter Einzel-Tag.
ISO 639-1 kennt meist zweibuchstabige, ISO 639-2 dreibuchstabige Sprachcodes. Ein BCP-47-Tag nutzt registrierte Sprach-Subtags und kann weitere Angaben enthalten; dieses Werkzeug konvertiert nicht beliebig zwischen den Normen.
BCP 47 bezeichnet Sprach-Tags für Webinhalte und Lokalisierungs-APIs. Verwenden Sie die Prüfung, wenn Reihenfolge, Registrierung oder bevorzugte Form eines vorhandenen Tags unklar sind.
Bei Chinesisch ist die Schrift mit Hans oder Hant oft wichtiger als die Region. zh-Hant-TW zerlegt diese beiden Angaben getrennt, damit Region und Schreibsystem nicht verwechselt werden.
Nein. Hier wird ein BCP-47-Tag geprüft und bei alten Codes eine bevorzugte Form vorgeschlagen. POSIX-, ICU- und ISO-Kataloge werden nicht als allgemeiner Konverter zusammengeführt.
Registrierte Varianten-Subtags werden erkannt. Das Werkzeug erzeugt jedoch keinen Code aus einem freien Dialektnamen und sagt auch nicht, ob Ihre Anwendung den Dialekt tatsächlich anbietet.
Einen Tag falsch gelesen?
Original, kanonischen Vorschlag und IANA-Datum vergleichen; bei Bedarf Headergewichte oder die getrennte RTL-Vorschau öffnen.