01
按输入类型切换
只有一个语言标签时用默认模式;复制了完整 Accept-Language 行时切到标头模式。后者可识别字段名前缀和分号后的 q 值。
Unicode / 国际化
单个标签和 Accept-Language 标头分开解析,避免把 q 参数误当子标签。
仅在当前浏览器解析;不会发送或保存输入。
解析中…
IANA 注册表快照:…
解析中…
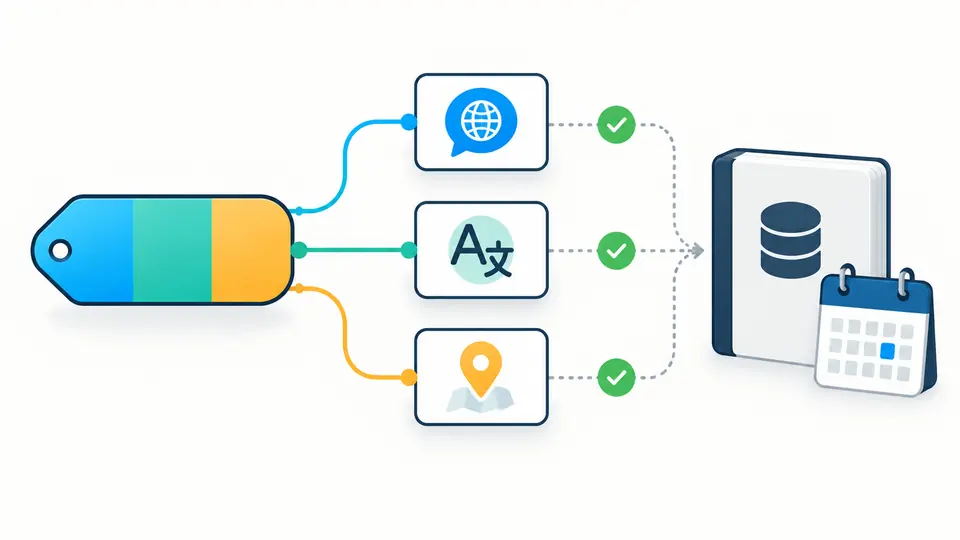
配置多语言路由时,zh-Hant-TW 里的 Hant 是文字体系,TW 才是地区。BCP 47 语言标签解析会把原值与字段并排保留,方便发现顺序和大小写问题。
需要语言子标签查询、BCP 47 语言标签校验或语言代码规范化时,可直接看登记状态和建议形式。Accept-Language 权重另有模式,不会混进单标签判断。
BCP 47 语言标签解析先识别语言、文字体系、地区、变体和扩展,再按带日期的 IANA 快照核对公开子标签。浏览器接受某个写法,不代表它已经登记。
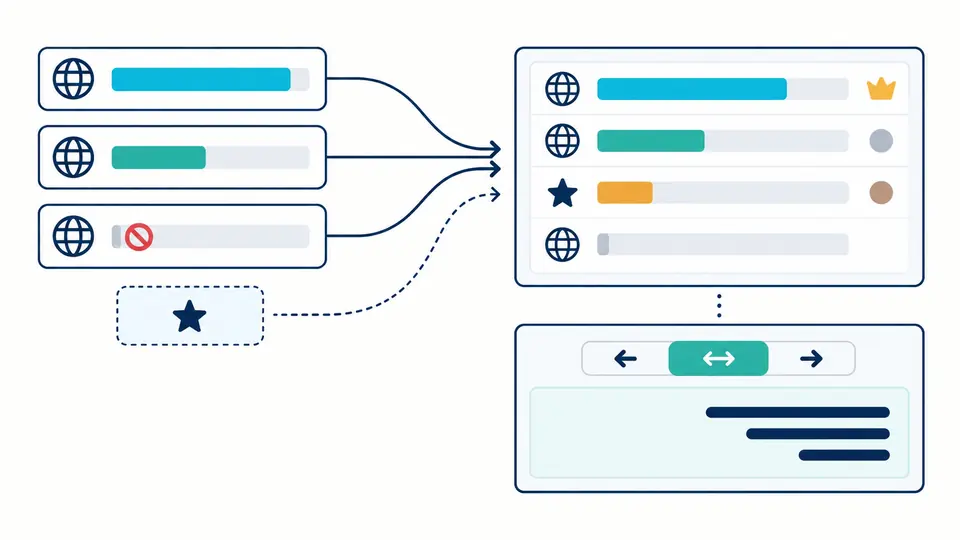
标头模式把缺省 q 视为 1,按权重排列语言范围;同权保留输入顺序,q=0 仍显示为“不接受”。结果不模拟网站最终选择。
只有一个语言标签时用默认模式;复制了完整 Accept-Language 行时切到标头模式。后者可识别字段名前缀和分号后的 q 值。
规范化建议只出现在结果里,不改原文。留意 IANA 注册状态和快照日期;私用 x- 标签语法成立,但没有公开可查询的子标签含义。
默认停顿 350 毫秒自动解析;关闭后用按钮或 Ctrl/Cmd+Enter。输入或方向选项改变会使旧结果过期,导出因此禁用。
语言、扩展语言、文字体系、地区、变体和扩展分别显示。重复变体或重复扩展标识会报错,不会在规范化中被悄悄合并。
IANA 注册表的 File-Date 会直接显示;已废弃代码给出优先值建议。浏览器自己的规范形式另列,避免把两套数据来源混为一谈。
Accept-Language 权重最多保留三位小数;未写 q 即为 1。星号是语言范围通配符,不是一个可登记的语言标签。
先写语言;仅在内容确实有文字体系或地区差异时再加对应子标签。解析结果能验证代码和顺序,却不能替你决定具体受众。
不宜只靠它。Accept-Language 表达请求偏好,不等于用户长期选择的地区设置;服务器还须结合应用支持列表和明确的用户偏好。
ISO 639-1 通常使用两字母语言代码,ISO 639-2 使用三字母代码。BCP 47 的主语言子标签可采用已登记的代码,但本页不执行两个标准间的任意转换。
中文常要区分 Hans 与 Hant 文字体系,再按需要加 CN、TW 等地区。zh-Hant-TW 的三个字段会分别显示;不要仅凭地区猜文字体系。
BCP 47 用连字符连接语言等子标签,例如 zh-Hant-TW;POSIX 常见下划线、编码后缀或 @ 修饰符。这里不会将后者当作有效 BCP 47 标签。
发现解析有误?