01
按所选语法粘贴数值
码点接受 U+0041、0x41 或 41;字节项必须为两位十六进制数,可加 0x 前缀。用空白或逗号分隔各项,不接受连续八位字节串、反斜杠转义或 HTML 实体。直接粘贴字符时选择文本模式。
Unicode 与国际化
输入原文、码点或字节,核对名称、计数和编码表示。
输出最多预览 4,000 个字符;复制和下载包含完整结果。文本预览使用转义诊断标记。
输入仅在当前浏览器中处理,不会上传。
文本上限为 10,000 个 UTF-16 代码单元。编码输入上限为 200,000 个字符,解码后仍不得超过 10,000 个代码单元。码点使用 U+HEX、0xHEX 或 HEX;字节使用两位十六进制数,可加 0x 前缀。用空白或逗号分隔,不接收转义或 HTML 实体。
名称数据:Unicode 17.0.0。字素分段:浏览器 Intl.Segmenter,其 Unicode 版本不可查询,可能与名称数据不同。正式名称与控制别名保留官方英文。
字节序由所选格式决定。保留开头的 U+FEFF,不检测、删除或添加 BOM,也不规范化输入。浏览器传入且未经编辑的 CR/CRLF 会保留;文本框将换行显示为 LF。
详细位置从 0 开始,以 UTF-16 代码单元计数,结束偏移不包含在范围内。错误行列和字节位置从 1 开始;缺失字节指向输入末尾之后。标量计数不包含孤立代理单元。
输入文本或载入示例。
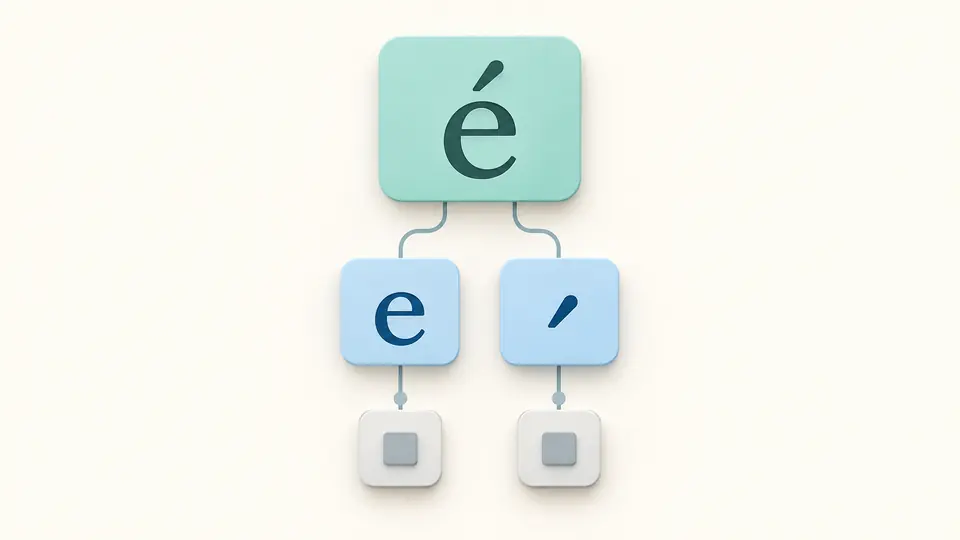
Unicode 字符检查器适合排查“看起来相同,比较却不相等”的文本。一个带重音字母既可能是单一码点,也可能由字母和组合符构成;只看字体渲染结果,很难找到存储方式的差别。
把出问题的短片段放进 Unicode 码点检查器,可以对照每项的名称和 UTF-8 字节。若手中只有日志里的十六进制值,也能先按明确的输入格式解码,再检查它实际代表什么,而不是把字节误当成字符编号。
Unicode 字符检查器同时列出有效标量码点、UTF-16 代码单元和字素。字母加组合重音可以显示为一个字素,却占两个码点;补充平面的单个表情则占两个代码单元。计数差异因此有了可核对的来源。
选择 UTF-8、UTF-16LE/BE 或 UTF-32LE/BE 字节输入,查看解码后的原文与各项细节。输出可切换为另一种字节表示,方便验证端序;发现无效序列时直接定位错误,不用替换符掩盖问题。
码点接受 U+0041、0x41 或 41;字节项必须为两位十六进制数,可加 0x 前缀。用空白或逗号分隔各项,不接受连续八位字节串、反斜杠转义或 HTML 实体。直接粘贴字符时选择文本模式。
默认开启自动检查,编辑停顿 250 ms 后刷新;关闭后点击检查或按 Ctrl/Cmd+Enter。输入改变会使旧结果过期并禁用导出。已有内容时,示例和清空先显示替换预览,应用后可撤销恢复。
默认输出 JSON 报告,可切换文本或编码格式。详细列表每次展开 50 项,输出预览最多显示 4,000 个字符,复制与下载始终使用全量。文本预览中的转义标记只用于观察,合法文本导出的是实际字符。
名称采用 Unicode 17.0.0 官方数据及规则命名范围,英文正式名称不翻译。控制别名单列;私用值、非字符、孤立代理以及该版本未分配的值分别标识,不把缺少正式名称解释成检测失败。
每项列出 UTF-8 字节、UTF-16 代码单元与 UTF-32 标量值。完整输出还可选择大小端字节序列。四位十六进制代码单元只用于显示或导出,不作为另一种反向输入语法。
详细范围以 UTF-16 单元从 0 开始,末端偏移不计入范围。错误行列和字节位置从 1 开始;缺少的字节指向输入之后的位置。这些坐标不是按字体显示宽度计算的屏幕列。
码位或码点是 Unicode 编码空间中的数值位置,通常写成 U+ 加十六进制数,例如 A 是 U+0041。并非每个位置都分配给字符;代理范围也不是标量值,因此这里会把这些情况单独标注。
UTF-8 用一到四个字节表示一个标量值,UTF-16 用一个或两个 16 位代码单元表示。比如补充平面的表情需要一对 UTF-16 单元。字节、代码单元和眼睛看到的字素是不同计量,不能直接互换。
可以检查它们的 U+ 值及名称或控制别名。没有可见字形不意味着字符不存在,也不一定意味着有害;本页只呈现原始序列,不自动删除连接符、方向控制或特殊空格。
会。正式名称来自 Unicode 17.0.0 数据,保留英文原名;控制别名另行标注。私用值、非字符和未分配值可能没有正式名称,页面会说明类型,不生成看似正式的自创名称。
可以。补充平面码点不会被拆成两个有效字符;由多个码点组成的家庭表情等序列,可在字素视图中查看分组。分组结果依赖浏览器的分段实现,并不保证不同浏览器使用同一 Unicode 版本。
发现名称、字节或边界与预期不符?