01
从 NFC 开始看四种结论
默认选择 NFC,但四种形式同时检查。不要只凭屏幕上字形判断;展开变化区段,看 U+ 码点与 UTF-8 字节是否改变。
Unicode 与国际化
四种形式同时对照原文;选择一种结果,再核对变化区段。
预览最多显示 4,000 个字符;复制与下载包含完整结果。
文字只在当前浏览器处理,不会上传。
最多输入 10,000 个 UTF-16 单元;超限直接拒绝,不截断。
规范化由当前浏览器实现,不声称固定 Unicode 版本。
输入文字或选择示例。
明明看起来一样,检索却对不上?一个“é”可能是单一码点,也可能是字母加组合重音。Unicode 规范化让这两种存储序列的差别可见,而不靠肉眼猜。
需要统一文件名或表单文本时,先用 Unicode 规范化检查 NFC 与 NFD 的变化。NFKC、NFKD 还可能折叠全角和上标,应用前应看清原文与结果。
把视觉相似与存储相同分开判断。
Unicode 正规化检查不该把一个结果接着喂给下一种形式。这里让 NFC、NFD、NFKC、NFKD 分别对照原文,并标出哪一种已经一致。
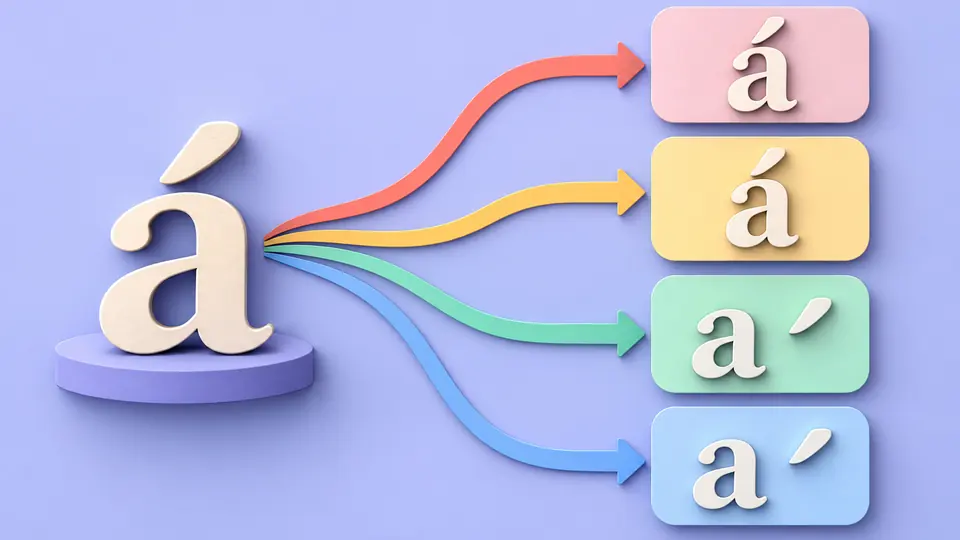
全角字母、合字或上标在 NFKC 转换后可能变成普通字符。Unicode 规范化工具保留原文,标亮变化区段,确认预览后才允许覆盖。
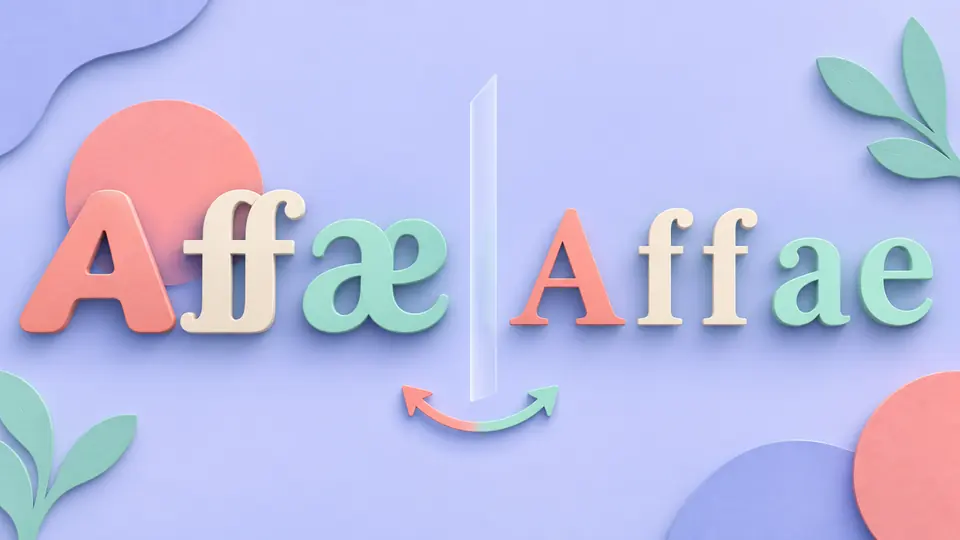
默认选择 NFC,但四种形式同时检查。不要只凭屏幕上字形判断;展开变化区段,看 U+ 码点与 UTF-8 字节是否改变。
整段模式保留原输入的换行;逐行模式把每一行当作独立记录,空行也保留,输出统一用 LF。需要保留 CRLF 时请选择整段。
页面预览可能缩短,复制和下载始终是完整结果。关闭自动检查后可用 Ctrl/Cmd+Enter 手动运行;把结果写回输入要先经过预览,并能撤销一次。
NFC 转换偏向组合形式,NFD 分解为规范等价序列;NFKC、NFKD 还处理兼容字符。四种形式各列出是否变化、码点数和字节数。
合成或分解不一定是一对一字符映射。高亮按连续变化区段组织,下面列出改动前后的 U+ 序列与十六进制字节。
预览只显示前 4,000 个字符,复制、下载使用完整结果。应用到输入前显示前后内容与数量,撤销会把原输入和旧结果一起恢复。
它把规范等价或兼容等价的字符序列转换到 NFC、NFD、NFKC、NFKD 之一。NFC 偏组合、NFD 偏分解;NFKC、NFKD 还会折叠兼容字符。四种结果都与原文独立比较。
一般文本常从 NFC 开始;若系统要求分解形式选 NFD。只有明确接受全角、合字等差异消失时才选 NFKC 或 NFKD,先看差异预览。
去除变音符号会删除音标,而 Unicode 规范化中的 NFD 只是把可分解字符拆成基字与组合符。此页不会执行删除,所以它不是去音标工具。
同一个可见字符的组合与分解序列可能使用不同数量的 UTF-8 字节。四形式概览给出字节总数,变化详情列出具体十六进制序列。
不总可逆。尤其 NFKC、NFKD 的兼容映射可能让几种原始写法得到同一结果,无法仅凭结果重建原文。本工具只在确认预览后覆盖输入。
还有意外的字符变化?