01
Elige el alcance
Una cadena basta para revisar escrituras y candidatos. Usa la segunda solo cuando conozcas una grafía de referencia; pegar una URL no abre ninguna página.
Unicode e internacionalización
Revisa escrituras, equivalencias y, si la tienes, una grafía de referencia.
El texto permanece en este navegador y no se sube.
Las tablas Unicode 18 de equivalencias y escrituras están incluidas localmente.
La comparación de esqueletos no reordena texto bidireccional; la normalización depende del navegador. Coincidir no demuestra seguridad ni peligro.
La entrada cambió. Vuelve a revisar antes de exportar.
Cuando un nombre de usuario parece correcto pero no coincide exactamente, el detector de homóglifos revela los puntos de código guardados. Una а cirílica entre letras latinas puede pasar inadvertida según la fuente.
Este examen de caracteres confundibles conserva el texto. Los caracteres Unicode similares y las escrituras mezcladas son pistas independientes; un ataque homógrafo no se puede deducir solo de ellas.
El detector de homóglifos marca una letra cirílica dentro de un nombre latino y señala su posición y punto de código. La mezcla pide una revisión; no demuestra suplantación.
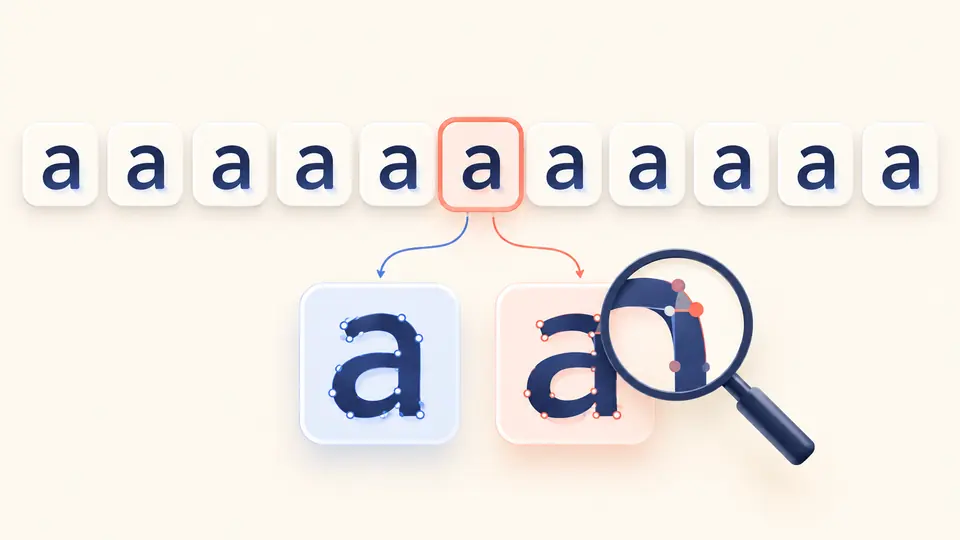
Dos cadenas con códigos distintos pueden compartir un esqueleto interno. Añade una grafía de referencia y examina cada equivalencia; el esqueleto no es un texto corregido para publicar.
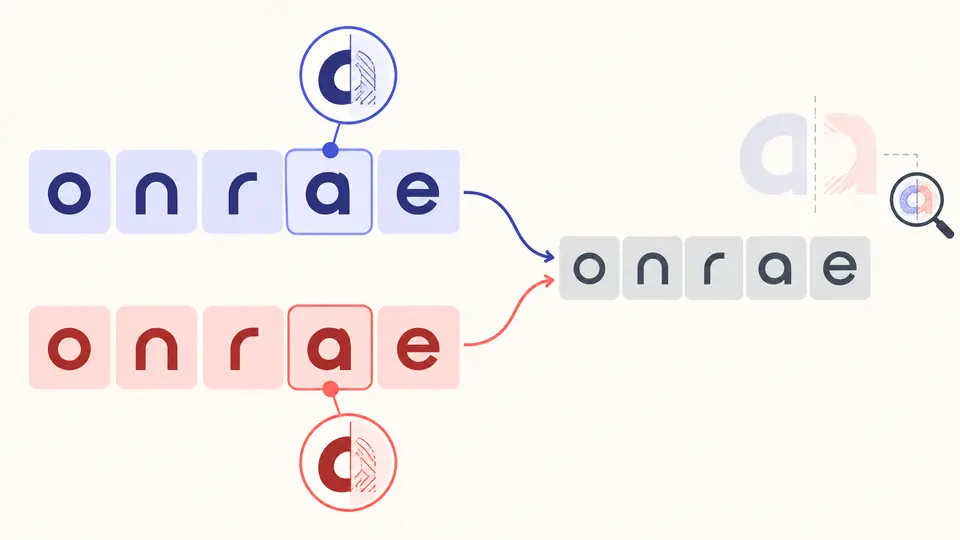
Una cadena basta para revisar escrituras y candidatos. Usa la segunda solo cuando conozcas una grafía de referencia; pegar una URL no abre ninguna página.
La revisión automática espera unos 350 ms tras editar. Si la desactivas, Ctrl/Cmd+Intro ejecuta la revisión. Un cambio en cualquiera de las cadenas bloquea la exportación anterior.
Una equivalencia puede abarcar varios caracteres y una letra extranjera puede ser normal. Mira primero el carácter original, la escritura y el contexto.
El comprobador incluye la tabla oficial completa de caracteres confundibles, también equivalencias con varios puntos de código, en lugar de una lista breve de letras latinas y cirílicas.
Una palabra enteramente cirílica puede tener candidatos sin mezclar escrituras. Una frase bilingüe puede mezclar alfabetos sin ser un intento de engaño.
La pantalla añade 100 caracteres cada vez. La copia y el JSON contienen todas las posiciones UTF-16, escrituras y equivalencias.
Es un carácter asociado en la tabla Unicode a un prototipo visualmente parecido. El parecido depende de la fuente y no dice nada sobre la intención.
Aquí nada cambia: no se produce un texto corregido. La equivalencia sirve para comparar, mientras la entrada y el informe conservan los caracteres originales.
Una línea solo cirílica no mezcla escrituras. Aun así puede contener candidatos; el informe muestra ambos indicios por separado.
Se usa toda la tabla fija de Unicode 18, pero no puede garantizar cada parecido posible bajo cualquier fuente o contexto.
No. El análisis ocurre dentro del navegador; copiar o descargar el informe requiere tu acción.
¿Falta una explicación?
Usa el detector de homóglifos con un nombre breve, añade una referencia conocida si corresponde y evalúa los puntos de código junto con el contexto.