Cloud Dev Helpers

Analyser un ID de ressource Azureet comprendre ses champs

Choisissez le format : identifiant ARM, URL de stockage ou chaîne de connexion. Consultez les champs extraits, les détails et le texte reconstitué.

Analyser un ID de ressource Azure

Entrée

Résultat

Traitement dans la mémoire de cette page, sans requête réseau ni historique enregistré.

Format et sortie

Le masquage couvre l’aperçu et les exports, pas le texte saisi. Les valeurs de requête et les champs de connexion inconnus sont également masqués.

Utilisez uniquement l’objet « fields » pour construire. Modifier les champs conserve les vraies valeurs dans l’entrée ; [REDACTED] ne permet pas de les reconstruire.

Vérification de structure uniquement : aucune validation en ligne des ressources, accès, clés ou connexions.

Limites : 32768 caractères, 100 paires clé-valeur et 128 segments d’ID.

Structure traitée. Le résultat actuel peut être exporté.

Analyser un ID de ressource Azure aide à lire un journal de déploiement. Pour un conteneur imbriqué, le nom final ne suffit pas : le compte, le service blob et les parents expliquent sa place.

Une chaîne de connexion Azure fournit des paramètres de connexion ; une URL de stockage, une adresse. Le parseur montre leurs champs sans déduire un groupe de ressources du seul nom de compte.

Pourquoi analyser un ID de ressource Azure ici ?

Passez du chemin complet aux champs modifiables sans perdre les relations entre ressources.

Garder chaque parent dans la lecture

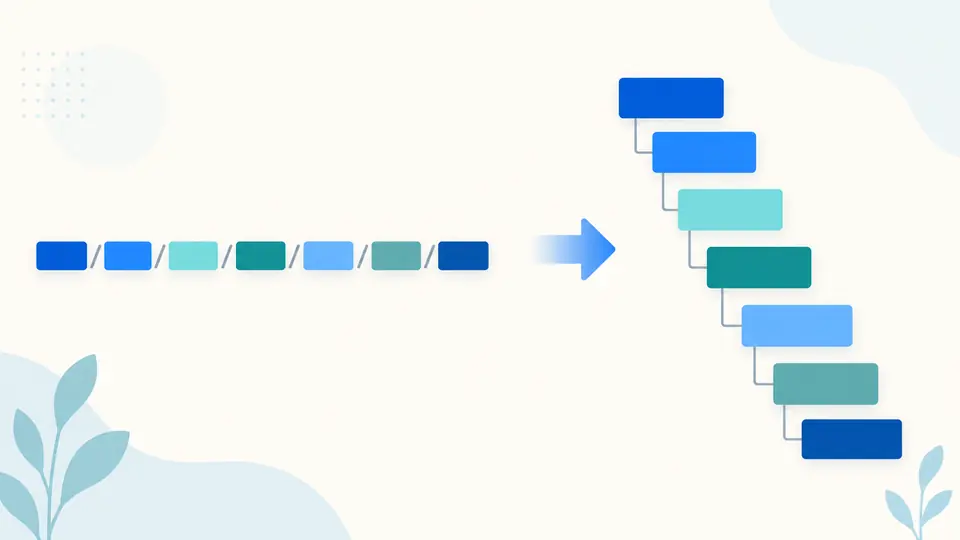
Analyser un ID de ressource Azure révèle chaque couple type-nom. Les blocs providers répétés restent distincts : une extension conserve son fournisseur et sa ressource parente.

Un long chemin de ressource se déplie en arbre avec plusieurs niveaux de parents et d’enfants.

Préparer un remplacement avant de l’appliquer

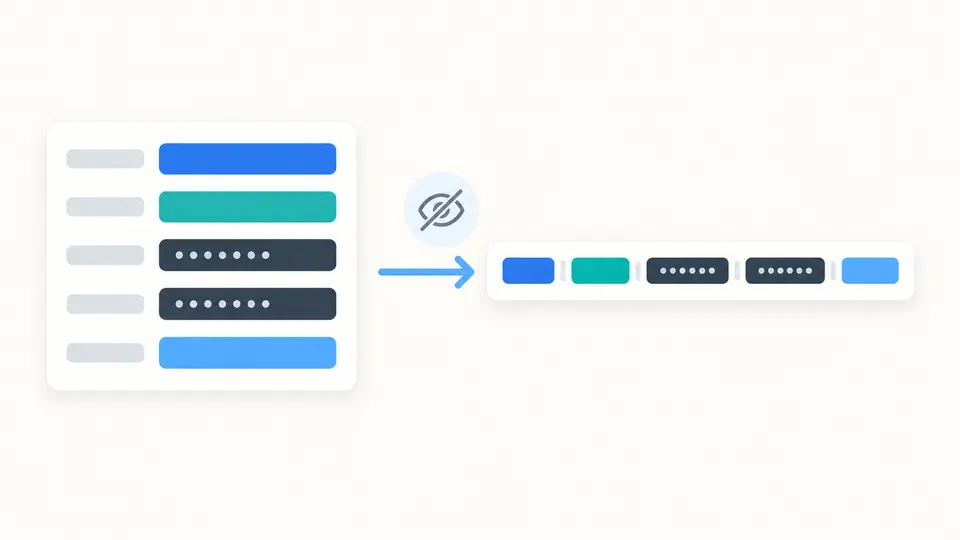
Modifier les champs prépare le JSON de construction. L’aperçu masque les secrets selon l’option active et indique la quantité remplacée. Après application, un rétablissement restaure entrée et résultat.

Des champs structurés sont assemblés en une chaîne dont les valeurs confidentielles sont recouvertes.

Trois points à connaître pour un aller-retour fiable

01

Partir du schéma correspondant au format

Le type se choisit explicitement. Exemple suit le type et le sens actifs. En construction, utilisez uniquement fields du rapport, sans details ni reconstructed.

  • Le champ kind du JSON doit correspondre au type sélectionné.
02

Choisir le moment du calcul

L’automatisme attend 350 ms. Désactivez-le pour préparer plusieurs changements, puis exécutez avec le bouton ou Ctrl/Cmd + Entrée. Un résultat périmé ne peut pas être exporté.

  • Changer le type, le sens ou le masquage rend aussi le résultat précédent périmé.
03

Distinguer aperçu masqué et entrée originale

Modifier les champs transfère les vraies valeurs vers l’entrée, même si l’aperçu les cache. Avant de diffuser un export, vérifiez l’option de masquage et le résultat visible.

  • Effacer et charger un exemple passent aussi par un aperçu, puis offrent un seul rétablissement.

Les champs conservés dans chaque format

Portées ARM et ressources imbriquées

Abonnement, groupe de ressources, locataire et groupe d’administration restent distinguables. Chaque fournisseur conserve ses couples type-nom. Un identificateur de ressource sans abonnement ou groupe garde null dans ces champs.

Adresses Storage sans réécriture du chemin

Les hôtes standard blob, dfs, file, queue et table sont reconnus dans trois clouds. L’encodage et les séparateurs du chemin restent intacts ; les paramètres gardent ordre et doublons.

Paires de connexion lisibles

Seul le premier signe égal sépare clé et valeur, préservant les clés Base64. Les formes Storage et Service Bus/Event Hubs sont reconnues ; les noms de champs répétés sont refusés.

Reconstruction soumise à la même grammaire

Le JSON doit respecter le schéma exact, sans champs supplémentaires. La chaîne reconstruite passe les mêmes contrôles d’analyse. Un résultat correct ne signifie pas que la connexion fonctionne.

Ce que le résultat ne peut pas établir

Existence et droits restent inconnus
Aucune ressource n’est interrogée et aucune connexion testée. Les règles de nommage des fournisseurs ne sont pas exhaustivement vérifiées. L’abonnement et le groupe absents ne peuvent pas être déduits.
Les secrets masqués ne sont pas récupérables
Les valeurs de requête et champs non autorisés sont cachés. Clés et signatures SAS ne sont ni générées, ni validées, ni renouvelées. [REDACTED] est refusé en construction ; l’entrée conserve ses valeurs.
Les hôtes personnalisés ne sont pas identifiés
Les URLs standard couvrent Azure public, Chine et US Government. Domaines personnels, hôtes privés, Azure Stack, ancien cloud allemand, sites statiques et Azurite sont exclus. Les chaînes acceptent cependant des points de terminaison personnalisés explicites.
Une grammaire de connexion volontairement limitée
SQL, ODBC, JDBC et URI AMQP génériques sont exclus. Le point-virgule sépare toujours les paires, sans échappement par guillemets. UseDevelopmentStorage=true reste un raccourci, sans insertion de clés ou d’adresses d’émulateur.
Un chemin ne prouve pas la nature du blob
Un segment unique peut désigner un conteneur ou un blob du conteneur racine. Cette ambiguïté reste ouverte. Aucun répertoire n’est confirmé ; points et barres obliques ne sont pas normalisés.
Pas d’import par lots ni de troncature silencieuse
Maximum : 32768 caractères, 100 paires de connexion ou de requête, 128 segments d’ID. Tout dépassement produit une erreur sans troncature. Ni fichiers importés, ni lots, ni historique. Une URL peut respecter la limite alors que son JSON développé la dépasse. La modification des champs refuse ce brouillon avant de remplacer la saisie.

Questions pour analyser un ID de ressource Azure

Comment extraire le groupe et le nom de la ressource à partir de son ID ?

Consultez resourceGroup et le détail resourceName. providers conserve les couples type-nom des parents. Analyser un ID de ressource Azure permet de situer une ressource enfant dans sa hiérarchie. Certaines portées n’ont pas de groupe.

Peut-on retrouver l’ID d’un compte de stockage avec sa chaîne de connexion ?

Généralement non. AccountName et les données d’authentification n’indiquent ni abonnement ni groupe. Retrouvez ces informations dans votre configuration ou par une requête de gestion autorisée ailleurs ; ce parseur ne les invente pas.

Où trouver le chemin complet d’un blob ?

Dans une URL standard, il suit l’hôte et précède le point d’interrogation. Consultez path et pathSegments ; l’encodage reste intact. Un segment seul peut aussi désigner un blob du conteneur racine.

Peut-on construire une URL de blob sans se connecter à Azure ?

Oui, si compte, service, suffixe du cloud et chemin sont connus. Modifiez les champs analysés ou utilisez l’exemple de construction. L’existence du blob, ses autorisations et la signature SAS restent non vérifiées.

Pourquoi les chaînes de connexion du portail et de PowerShell diffèrent-elles ?

Les sources peuvent utiliser des authentifications ou points de terminaison différents, par exemple clé de compte ou SAS. Les champs facultatifs et leur ordre varient aussi. Comparez-les à votre configuration ; le texte seul ne prouve pas des droits équivalents.

Une question sur votre format reste ouverte ?

Repartir avec des champs compréhensibles

Analyser un ID de ressource Azure est un point de départ pour comprendre sa hiérarchie. Choisissez ensuite le format utile et vérifiez le masquage avant l’export.

Une structure correcte ne garantit pas l’état d’une ressource Azure.