Cloud Dev Helpers

Azure Ressourcen-ID analysierenund Verbindungsdaten zerlegen

Ressourcen-ID, Speicher-URL oder Verbindungszeichenfolge auswählen. Die Ausgabe trennt Felder, abgeleitete Angaben und rekonstruierte Zeichenfolge.

Azure Ressourcen-ID analysieren

Eingabe

Ergebnis

Verarbeitung nur im Arbeitsspeicher dieser Seite, ohne Netzwerkanfragen oder gespeicherten Verlauf.

Format und Ausgabe

Schwärzt Vorschau und Export, nicht den ursprünglichen Eingabetext. Auch unbekannte Verbindungsfelder und Abfragewerte werden verdeckt.

Zum Aufbauen nur das Objekt „fields“ verwenden. „Felder bearbeiten“ übernimmt echte Werte in die Eingabe; [REDACTED] lässt sich nicht rekonstruieren.

Prüft ausschließlich die Struktur. Ressourcen, Berechtigungen, Schlüssel und Verbindungen werden nicht online geprüft.

Grenzen: 32768 Eingabezeichen, 100 Schlüssel-Wert-Paare und 128 ID-Pfadsegmente.

Struktur verarbeitet. Das aktuelle Ergebnis kann exportiert werden.

Sie möchten eine Azure Ressourcen-ID analysieren, weil ein Deploymentfehler einen langen Ressourcenbezeichner enthält? Bei Unterressourcen zählt jede Ebene: Container, Blobdienst und Speicherkonto. Die letzten beiden Pfadteile zeigen ihre Elternkette nicht.

Eine Azure Verbindungszeichenfolge und eine Speicher-URL enthalten andere Informationen als eine ARM-ID. Der Parser legt vorhandene Felder offen, ergänzt aber keine Ressourcengruppe, die in der Eingabe fehlt.

Warum eine Azure Ressourcen-ID analysieren?

Elternpfade verstehen und einzelne Felder bearbeiten, ohne ihren Zusammenhang zu verlieren.

Die vollständige Elternkette bleibt sichtbar

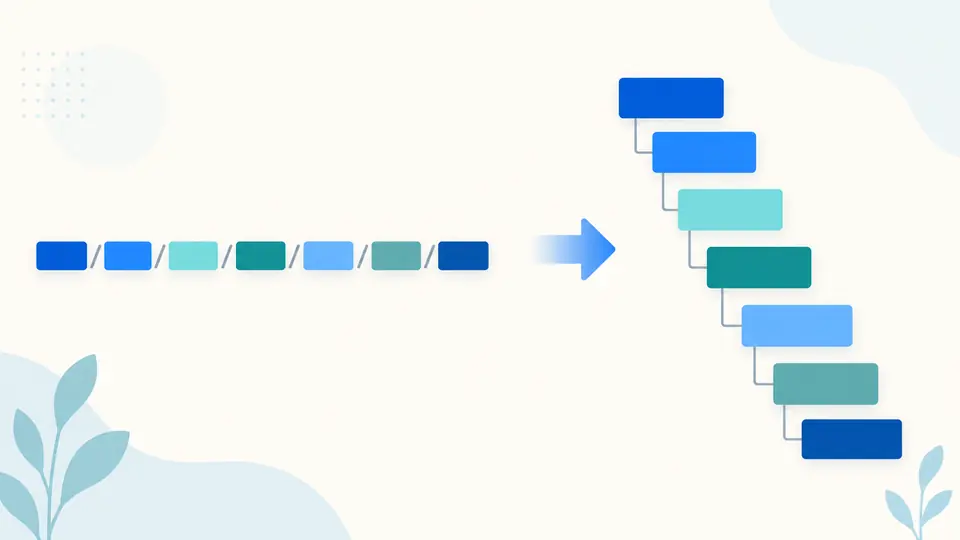
Wer eine Azure Ressourcen-ID analysieren will, braucht oft die Elternkette. Die Ausgabe erhält alle Typ-Name-Paare und trennt Providerblöcke, damit Unterressourcen und Erweiterungen unterscheidbar bleiben.

Ein langer Ressourcenpfad wird in einen Baum mit mehreren Eltern- und Kindebenen zerlegt.

Aus Feldern wieder eine Zeichenfolge erzeugen

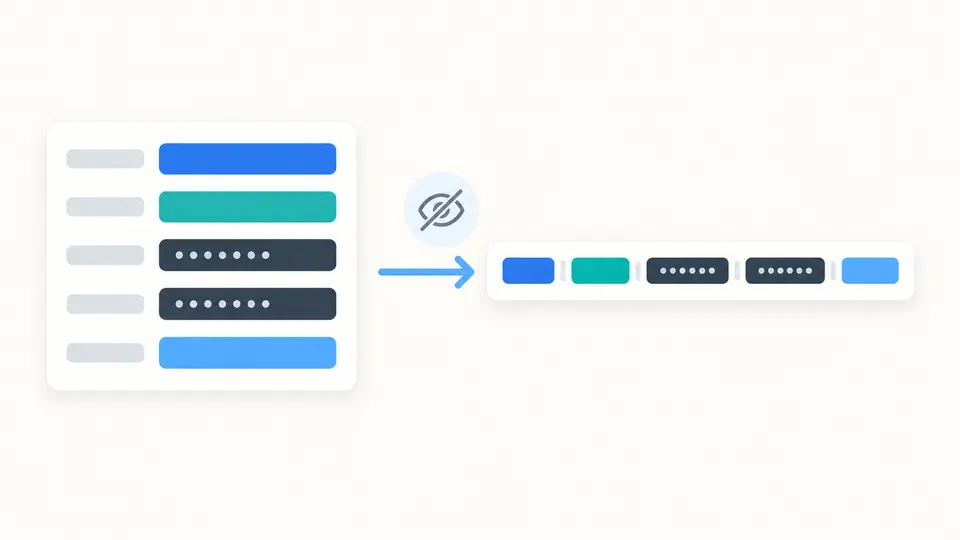
„Felder bearbeiten“ bereitet das passende JSON vor. Erst „Anwenden“ ersetzt die Eingabe. Die erzeugte Zeichenfolge folgt derselben Schwärzungsoption wie das strukturierte Ergebnis.

Ein strukturiertes Feldobjekt wird zu einer Zeichenfolge zusammengesetzt; vertrauliche Werte sind verdeckt.

Drei Details vor dem ersten Export

01

Das richtige Format ausdrücklich wählen

Wählen Sie den Eingabetyp ausdrücklich. Das Beispiel gehört zur aktuellen Auswahl und liefert in Aufbaurichtung das benötigte JSON-Schema.

  • Ein Analysebericht enthält „fields“, „details“ und „reconstructed“. Nur „fields“ gehört in den Aufbaueditor.
02

Aktualisierung und Schwärzung prüfen

Automatisch wird nach 350 ms Ruhe verarbeitet. Ohne Automatik starten Sie per Schaltfläche oder Strg/Befehl + Enter. Eingabe- und Optionsänderungen sperren den Export bis zur erneuten Verarbeitung.

  • Die Schwärzung verändert nicht Ihre Eingabe; beim Bearbeiten von Feldern stehen dort weiterhin die Originalwerte.
03

Ersetzungen zunächst in der Vorschau ansehen

Beispiel, Leeren und Felder bearbeiten zeigen vorab die ersetzte Zeichenzahl. Einmaliges Rückgängigmachen stellt Eingabe und Ergebnis zusammen wieder her. Für vollständige Verbindungsstrings muss die Schwärzung ausgeschaltet sein.

  • Ein exportierter [REDACTED]-Platzhalter kann keine verlorenen Schlüssel wiederherstellen.

Welche Informationen die drei Formate liefern

ARM-Bereiche und Providerketten

Abonnement, Ressourcengruppe, Mandant und Verwaltungsgruppe werden strukturell unterschieden. Wiederholte providers-Blöcke bleiben getrennt; fehlende Abonnement- oder Gruppenfelder erscheinen als null.

Speicherdienst und unveränderter Pfad

Standardhosts für blob, dfs, file, queue und table werden drei Clouds zugeordnet. Pfadkodierung, wiederholte Schrägstriche und Punktsegmente bleiben erhalten. Abfrageparameter behalten Reihenfolge und Wiederholungen.

Verbindungspaare ohne verlorene Gleichheitszeichen

Getrennt wird am ersten Gleichheitszeichen. Weitere Gleichheitszeichen, etwa in Base64-Schlüsseln, gehören zum Wert. Storage und Service Bus/Event Hubs werden unterstützt; doppelte Feldnamen führen zu einem Fehler.

Nachvollziehbarer Aufbau aus JSON

Die Gegenrichtung erwartet das genaue Feldschema, weist zusätzliche JSON-Felder ab und prüft die aufgebaute Zeichenfolge erneut. Struktur und Text werden ausgegeben, ohne eine funktionierende Anmeldung zu behaupten.

Grenzen der Strukturprüfung

Keine Ressourcenabfrage und kein Verbindungstest
Das Ergebnis beweist weder Existenz noch Zugriff. Provider- und Namensregeln werden nicht vollständig geprüft. Abonnement und Ressourcengruppe müssen bekannt sein; ein Speicherkontoname reicht nicht zur Ergänzung.
Schwärzung ist keine Schlüsselverwaltung
Abfragewerte und nicht freigegebene Verbindungsfelder werden verdeckt. SAS-Signaturen und Schlüssel werden weder erzeugt noch geprüft oder erneuert. Originalwerte bleiben in der Eingabe; [REDACTED] wird beim Aufbau abgewiesen.
Speicher-URLs brauchen einen Standardhost
Unterstützt sind Azure Public, China und US Government. Eigene Domains, private Hosts, Azure Stack, die frühere deutsche Cloud, Websiteendpunkte und Azurite-URLs sind ausgeschlossen. Explizite Verbindungsendpunkte dürfen eigene Hosts enthalten.
Keine vollständige Datenbankgrammatik
SQL, ODBC, JDBC und allgemeine AMQP-URIs sind ausgeschlossen. Semikolons trennen immer Einträge, ohne Anführungszeichen-Escapes. UseDevelopmentStorage=true wird erhalten, aber nicht in Emulatoradressen oder Standardschlüssel aufgelöst.
Pfadsegmente sind keine Containerabfrage
Ein Segment kann einen Container oder einen Blob im Stammcontainer bezeichnen. Diese Mehrdeutigkeit bleibt offen. Virtuelle Ordner werden nicht als echte Verzeichnisse bestätigt; der Pfad wird nicht normalisiert.
Eine Eingabe mit festen Obergrenzen
Maximal 32768 Zeichen, 100 Verbindungspaare beziehungsweise Abfrageeinträge und 128 ID-Segmente. Überschreitungen erzeugen Fehler statt stiller Kürzung. Dateiimport, Stapelverarbeitung und Verlauf sind nicht vorgesehen. Eine URL kann noch unter der Grenze liegen, während ihr JSON-Entwurf zu lang wird. Felder bearbeiten lehnt diesen Entwurf vor dem Ersetzen der Eingabe ab.

Fragen zu „Azure Ressourcen-ID analysieren“

Wie lassen sich Ressourcengruppe und Ressourcenname aus einer ID auslesen?

Wählen Sie Ressourcen-ID und lesen Sie resourceGroup und resourceName. providers enthält alle übergeordneten Typ-Name-Paare. Eine Azure Ressourcen-ID analysieren hilft, Unterressourcen ihrem Elternpfad zuzuordnen. Bei manchen Bereichen darf die Ressourcengruppe fehlen.

Lässt sich die Ressourcen-ID aus einer Speicher-Verbindungszeichenfolge ermitteln?

Im Allgemeinen nicht. AccountName und Zugangsdaten enthalten normalerweise keine Abonnement-ID oder Ressourcengruppe. Sie benötigen diese Angaben aus Ihrer Konfiguration oder einer berechtigten Verwaltungsabfrage außerhalb dieses Tools.

Wo finde ich den Pfad zu einem Blob?

In einer Standard-Speicher-URL steht er nach dem Host und vor dem Fragezeichen. Die Ausgabe zeigt path und pathSegments mit unveränderter Kodierung. Ein einzelnes Segment kann auch einen Blob im Stammcontainer meinen.

Kann ich eine Blob-URL ohne Verbindung zu Azure zusammensetzen?

Ja, wenn Konto, Dienst, Cloudsuffix und Pfad bekannt sind. Bearbeiten Sie analysierte URL-Felder oder verwenden Sie das Aufbaubeispiel. Die erzeugte Adresse bestätigt weder Existenz noch Leserechte oder eine gültige SAS-Signatur.

Warum unterscheiden sich Verbindungszeichenfolgen aus Portal und PowerShell?

Die Quellen können unterschiedliche Authentifizierung, Endpunkte oder optionale Felder verwenden, etwa Kontoschlüssel statt SAS. Vergleichen Sie die Paare mit Ihrer tatsächlichen Konfiguration. Feldreihenfolge und Textunterschiede allein erklären keine Zugriffsrechte.

Fehlt eine Antwort zu Ihrem Eingabeformat?

Mit einer nachvollziehbaren Struktur weiterarbeiten

Jetzt eine Azure Ressourcen-ID analysieren oder das passende Verbindungsformat auswählen. Prüfen Sie vor dem Kopieren die Aktualität und die gewählte Schwärzung.

Das Ergebnis beschreibt die Zeichenfolge, nicht den Zustand Ihrer Azure-Ressourcen.